pyplAI-MCPProyecto personal. Servidor MCP open source.
La búsqueda de pyplAI, como herramienta para cualquier LLM.
Un servidor MCP que pone los algoritmos de pyplAI al alcance de asistentes como Claude. El modelo juega, pide el análisis de cada posición y explica su jugada con las cifras de la búsqueda. En Phantom, con las fichas del rival ocultas, el análisis solo usa lo que el jugador sabe.
- juegos, uno con información oculta
- 3
- partidas de benchmark con Llama 3.2 3B
- 960
Hecho con Python, MCP, Pydantic y pyplAI.
El problema
Los modelos de lenguaje razonan con palabras, pero no buscan. Si le pides a uno que juegue al Ultimate Tic-Tac-Toe, explicará bien sus jugadas y las elegirá mal. pyplAI, mi TFG, hace justo lo contrario: busca, pero no explica nada.
Quise juntar las dos cosas con el Model Context Protocol (MCP), el estándar con el que asistentes como Claude usan herramientas externas: que el modelo juegue, pida a pyplAI el análisis de la posición y explique su jugada con las cifras de la búsqueda.
Siete herramientas y un juego con información oculta
El servidor expone pyplAI como siete herramientas: ver los juegos y sus reglas, empezar una partida, consultar el estado, jugar, analizar la posición y terminar. La clave es analyze_position: lanza una búsqueda desde la posición del modelo y le devuelve sus jugadas legales ordenadas por el porcentaje de partidas simuladas que ganan. Esta es una respuesta real en Ultimate:
{
  "algorithm": "mcts",
  "metric": "win_rate",
  "best_move": "B1:a3",
  "moves": [
    {"move": "B1:a3", "visits": 121, "value": 0.4711},
    {"move": "B1:c1", "visits": 70, "value": 0.4357},
    {"move": "B1:c3", "visits": 89, "value": 0.4326}
  ],
  "iterations": 777,
  "seconds": 2.001
}
Phantom es donde el diseño importa. Es un cuatro en raya en un tablero de 4 × 4 en el que no ves las fichas del rival. Una búsqueda de información perfecta leería las fichas ocultas del estado del juego y haría trampa, así que el servidor solo ofrece las variantes ISMCTS de pyplAI, que muestrean dónde podrían estar esas fichas a partir de lo que el jugador sabe. Un test juega partidas completas y comprueba que nada de lo que recibe el jugador revela una ficha oculta.
Claude jugando
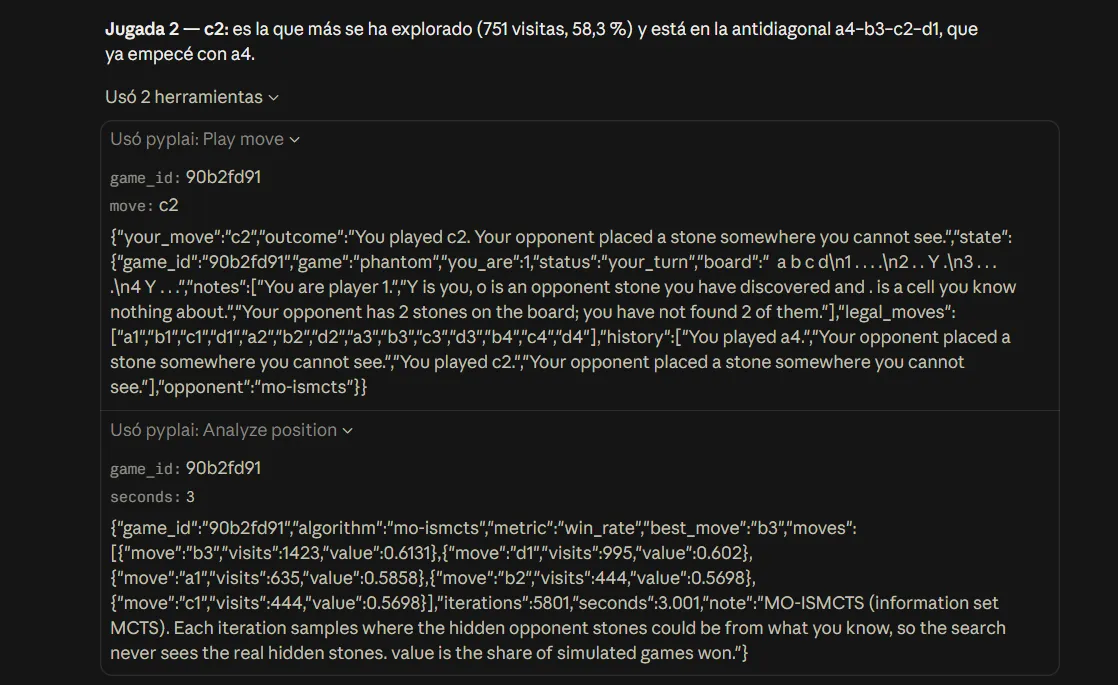
Así se ve desde Claude Desktop: Claude analiza cada posición, juega la jugada recomendada y explica por qué con las cifras del análisis. En esta partida de Phantom contra MO-ISMCTS ganó en cuatro jugadas (conversación completa).
Probarlo con un cliente real destapó dos fallos que los tests no cubrían. El modelo no tenía forma de leer las reglas, que estaban publicadas como recurso MCP y no como herramienta, así que añadí get_rules. Y al final de algunas partidas de Phantom el servidor describía mal la última jugada; ahora hay un test que reproduce ese final.
¿Cuánto ayuda la búsqueda a un modelo pequeño?
Una partida es una anécdota. Para medirlo escribí un agente que hace de cliente MCP y deja jugar, sin supervisión, a Llama 3.2 3B, servido en local con Ollama en la GPU de 4 GB de mi portátil. En cada juego compiten cuatro jugadores: Llama solo, Llama con analyze_position, la búsqueda sola como techo y las jugadas al azar como suelo. En total, 960 partidas.
Ver los datos
| Juego | Jugador | Partidas | Victorias | Empates | Derrotas |
|---|---|---|---|---|---|
| Tres en raya | Llama solo | 100 | 0 % | 0 % | 100 % |
| Tres en raya | Llama + búsqueda | 100 | 3 % | 66 % | 31 % |
| Tres en raya | Solo búsqueda | 100 | 0 % | 100 % | 0 % |
| Tres en raya | Al azar | 100 | 0 % | 8 % | 92 % |
| Ultimate | Llama solo | 40 | 0 % | 0 % | 100 % |
| Ultimate | Llama + búsqueda | 40 | 0 % | 8 % | 93 % |
| Ultimate | Solo búsqueda | 40 | 83 % | 8 % | 10 % |
| Ultimate | Al azar | 40 | 0 % | 0 % | 100 % |
| Phantom | Llama solo | 100 | 57 % | 1 % | 42 % |
| Phantom | Llama + búsqueda | 100 | 45 % | 28 % | 27 % |
| Phantom | Solo búsqueda | 100 | 48 % | 32 % | 20 % |
| Phantom | Al azar | 100 | 1 % | 25 % | 74 % |
- Solo, el modelo no juega mejor que el azar en los juegos de información perfecta. Pierde las 100 partidas de tres en raya y las 40 de Ultimate. Casi nunca intenta una jugada ilegal: el problema es elegir, no seguir las reglas.
- En tres en raya, la búsqueda baja sus derrotas del 100 % al 31 %. Analizó antes de cada jugada, pero solo jugó la recomendada el 80 % de las veces. En las 34 partidas en que siguió todas las recomendaciones empató las 34; las 31 derrotas llegaron en partidas en que se apartó de ella.
- En Ultimate no mejora: no gana ninguna partida y pierde 37 de 40, mientras que la búsqueda sola gana 33 de 40. Analizó antes del 67 % de sus jugadas y siguió el análisis en el 60 % de esas, pero nunca durante una partida entera.
- Phantom es distinto. Solo, ya gana el 57 % de las partidas, aunque pierde el 42 %. Con la búsqueda pierde el 27 %, cerca del 20 % de la búsqueda sola.
La conclusión: la herramienta ayuda a un modelo pequeño en la medida en que este se fía de ella. El método, las cifras con intervalos de confianza y el código para repetirlo están en el benchmark del repositorio.
Lo que aprendí
- Un modelo local también es infraestructura. Qwen3 4B seguía razonando aunque le desactivara el razonamiento y tardó 16 minutos en una partida de tres en raya, así que lo cambié por Llama 3.2 3B. Llama caía a veces en un bucle de texto (una respuesta llegó a 42 000 tokens), así que limité cada respuesta a 512 tokens; y cuando Ollama perdió por un momento la conexión con su propio proceso, añadí reintentos. Como el resultado se guarda partida a partida, cada corte se reanudó donde se había quedado.
- Medir lo que explica el resultado, no solo el resultado. El porcentaje de victorias decía que la herramienta servía de poco en Ultimate. Registrar si el modelo seguía la recomendación explicó por qué.
- Diseñar las herramientas para el modelo. Los errores que el modelo puede corregir, como una jugada ilegal, vuelven como errores legibles con la lista de jugadas legales. Y por la salida estándar solo viaja el protocolo: pyplAI 1.1 añadió
analiza()para devolver las estadísticas de la búsqueda como datos en lugar de imprimirlas.